
Roundtable Agents: Riset Multi-Agen di Graf Eksplisit
Pipeline riset lengkap dengan checkpoint tahan-restart dan perbandingan solo-vs-multi terukur yang dipublikasikan apa pun hasilnya, termasuk hasil negatif
- Proyek open source
- Agen AI
- Indonesia
- 16 Agustus 2026
Tangkapan layar
Gambar tidak dapat dimuat.
Gambar tidak dapat dimuat.
Gambar tidak dapat dimuat.
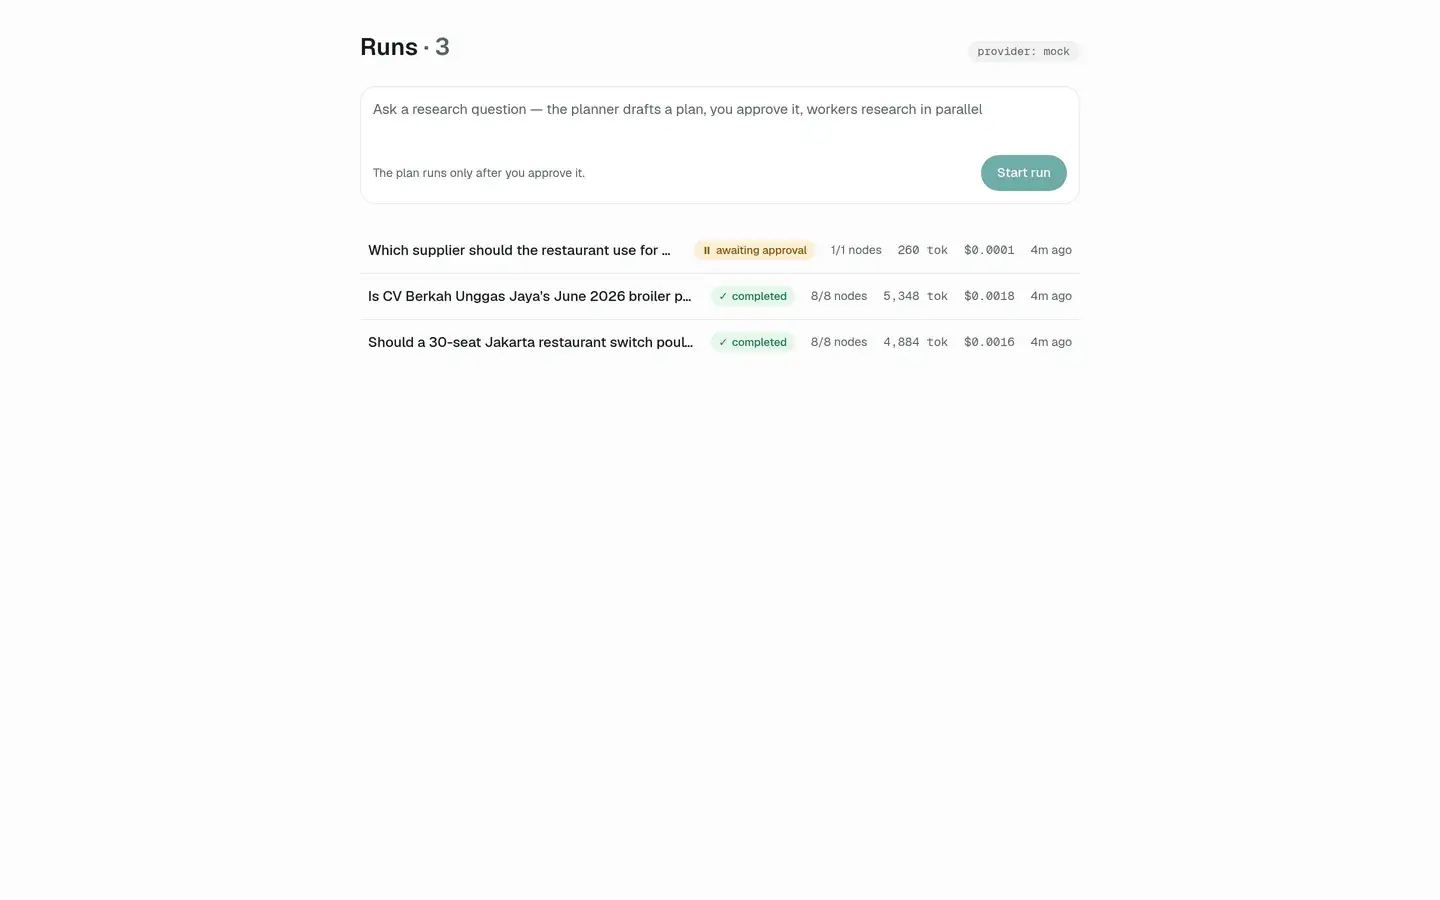
Gambar tidak dapat dimuat.
Masalahnya
Demo multi-agen biasanya berhenti di bagian yang mudah: beberapa agen dipanggil berurutan, lalu hasilnya digabung. Bagian yang menentukan apakah sistem seperti itu bisa dipercaya justru dilewati — tidak ada anggaran token yang benar-benar ditegakkan, tidak ada checkpoint yang selamat dari matinya proses, dan persetujuan manusia hanya berupa flag status yang hilang saat aplikasi restart. Lebih buruk lagi, klaim “lebih baik dari satu agen” hampir tidak pernah diukur; ia dibenarkan oleh intuisi.
Yang kami bangun
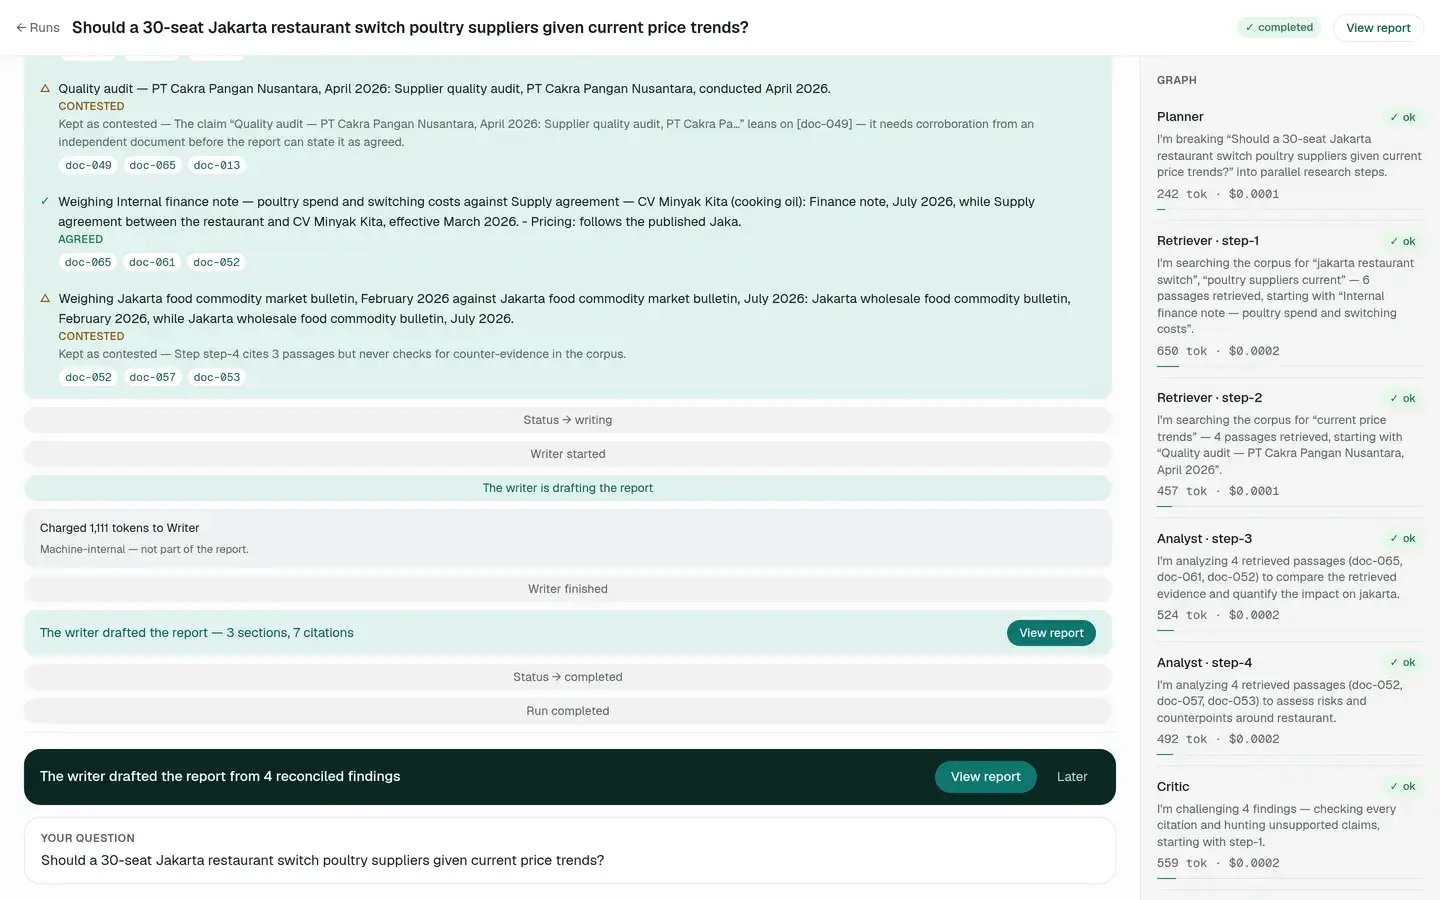
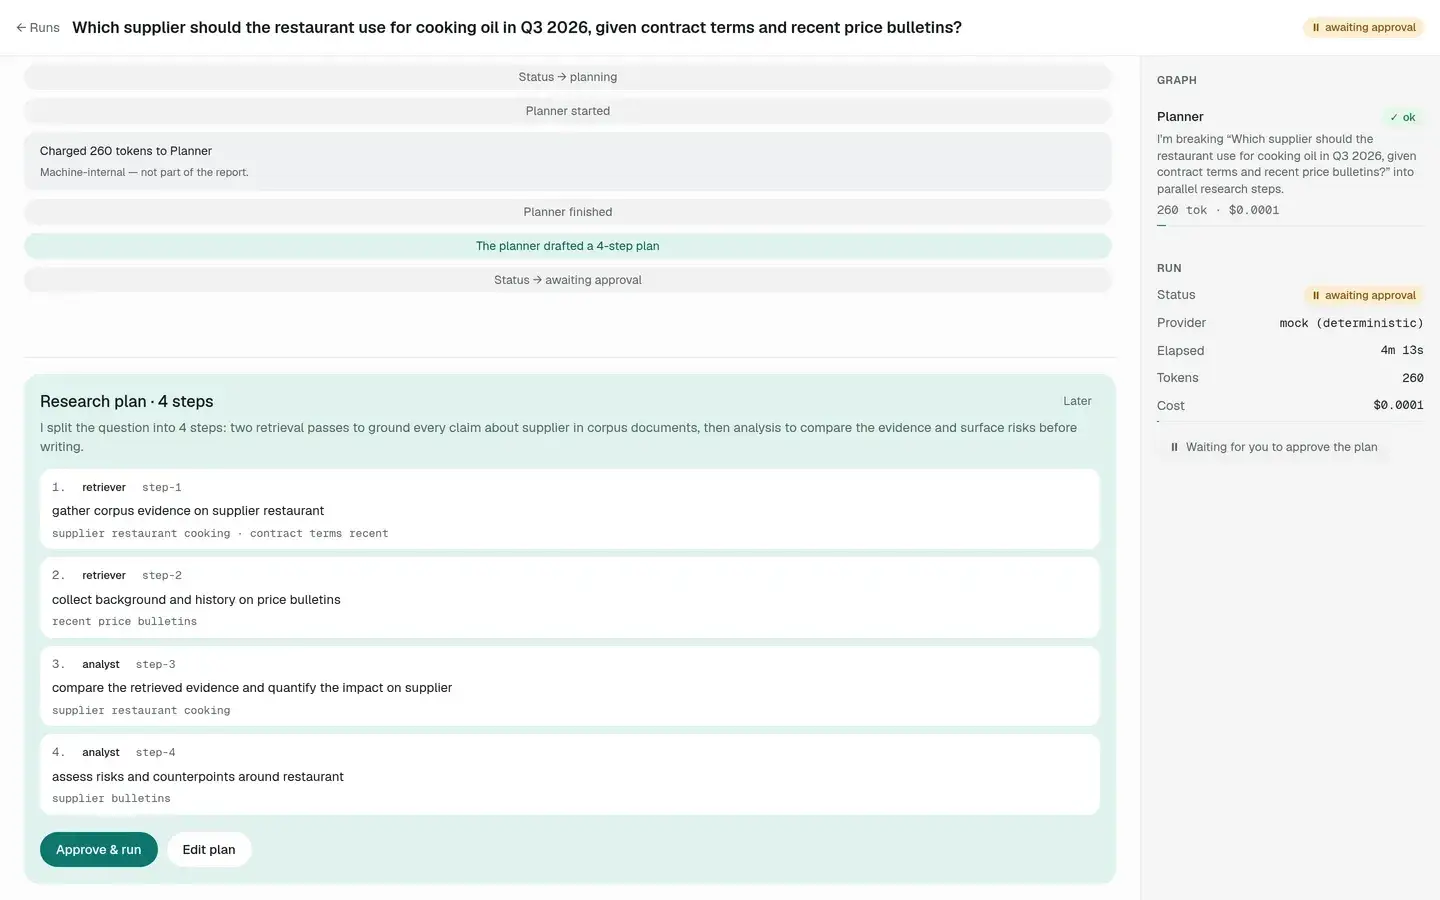
Sistem riset dan penulisan laporan di atas graf LangGraph eksplisit — node dan edge
bernama, bukan abstraksi “crew”: planner menyusun rencana, rencana berhenti di
gerbang persetujuan manusia (sebuah interrupt LangGraph, bukan flag), worker
paralel dikerahkan per langkah rencana, critic menantang temuan, consensus
merekonsiliasi temuan terhadap kritik menjadi klaim agreed / contested /
dropped, dan writer men-stream laporan akhir ke UI.
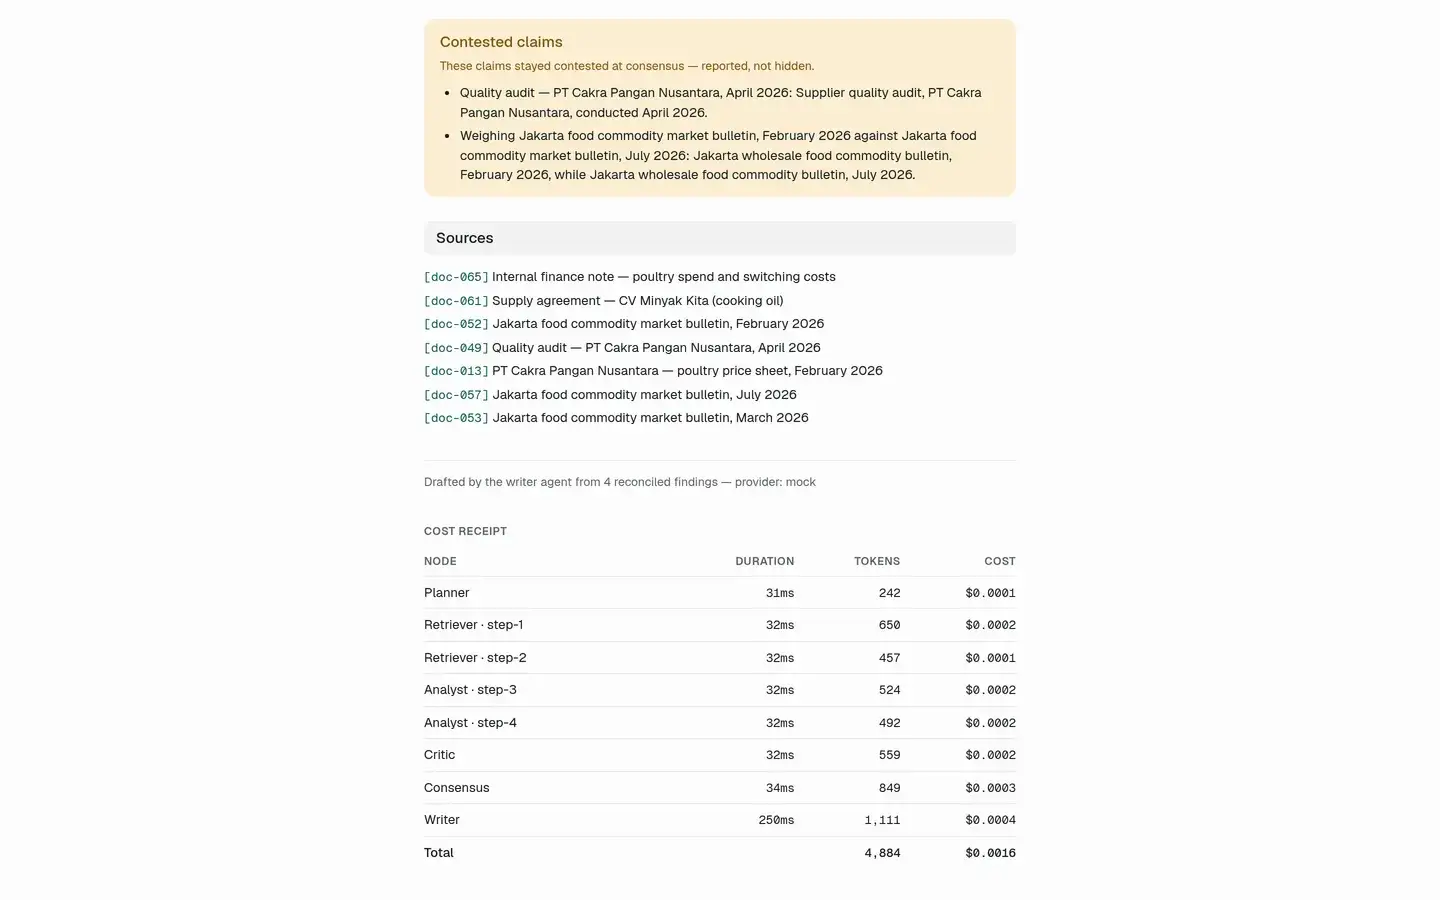
Klaim yang berhasil digugat critic tetap muncul di laporan akhir di bawah heading sendiri, lengkap dengan alasan ketidaksepakatannya. Ketidaksepakatan dilaporkan, tidak pernah disembunyikan.
Keputusan rekayasa
Graf eksplisit, bukan abstraksi kru. Anda tidak bisa memberi checkpoint, anggaran, atau interrupt pada sesuatu yang tidak bisa Anda tunjuk. Node bernama dengan input/output bertipe adalah syarat agar tiga hal itu mungkin.
Gerbang persetujuan adalah interrupt, bukan flag. Flag yang diperiksa kode aplikasi hilang bersama prosesnya. Interrupt adalah posisi ter-checkpoint: matikan backend saat rencana menunggu persetujuan, nyalakan lagi, dan run berlanjut dari gerbang itu.
Anggaran ditegakkan oleh ledger atomik. Setiap pemanggilan agen dibebankan ke ledger dengan semantik charge-then-raise — pemakaian dicatat sebelum exception, karena tokennya memang sudah terbayar. Default 8.000 token per node dan 40.000 per run; di profil Docker, ledger-nya skrip Lua di Redis agar worker paralel tidak bisa berlomba melewati plafon.
Hasil yang diukur
Repo ini mengirim perbandingan satu agen vs roundtable: 10 pertanyaan golden, dua lengan
dengan retrieval dan anggaran yang sama. Hasil live (deepseek-v4-flash), dipublikasikan
sebagaimana terukur: secara agregat roundtable tidak mengalahkan satu agen yang baik —
coverage berimbang (0,753 vs 0,767) dengan biaya ~5,5x token dan ~4,7x waktu. Yang menarik
ada di pembagian per kesulitan: pada pertanyaan conflicting yang menuntut rekonsiliasi
dokumen yang bertentangan, roundtable menang (0,53 vs 0,42). Dan 21 klaim contested adalah
artefak yang tidak bisa dihasilkan satu agen.
Angka-angka mock provider di README diberi label terpisah: ia mengukur plumbing pipeline, bukan kualitas model, dan tidak pernah disajikan sebagai hasil model.
Menjalankannya
git clone https://github.com/ridwanspace/roundtable-agents, lalu make install && make demo — run end-to-end di terminal, offline, tanpa satu pun API key, di atas mock provider
deterministik. make compose-up menambahkan checkpoint Postgres dan ledger Redis.
Reproduksi perbandingannya dengan make compare.
Proyek terkait
Ada proses serupa di tim Anda?
Ceritakan alur kerja dan kendalanya. Kita mulai dengan lingkup yang bisa dijelaskan dan diperiksa.