
Pandu: Platform RAG Self-Hostable dan Terukur
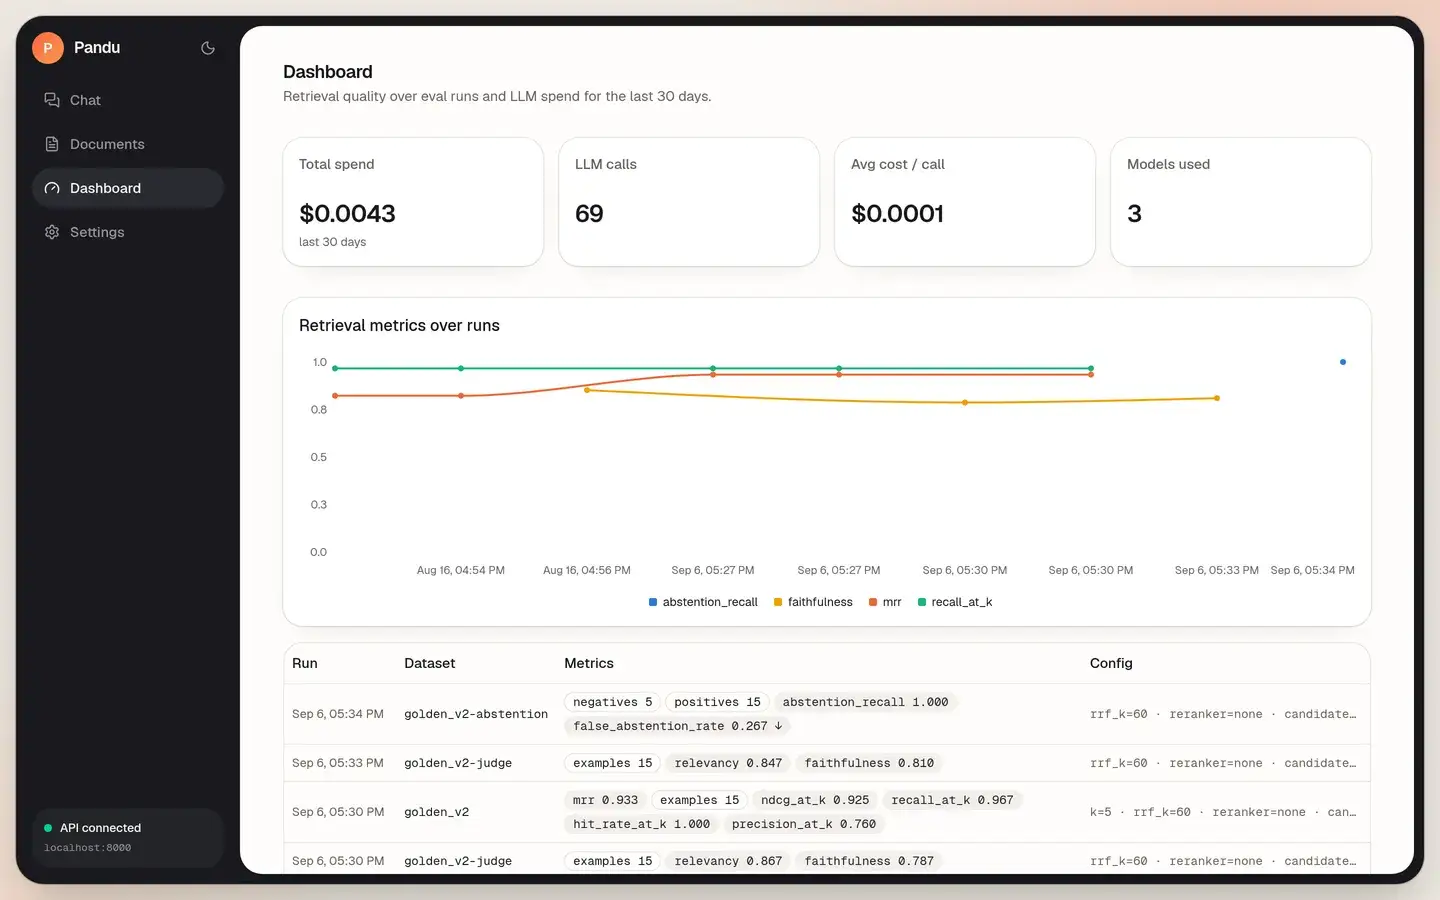
Retrieval hybrid terukur recall@5 0,967 pada golden set NIST, dengan gate CI yang gagal pada regresi apa pun — termasuk satu gate yang sengaja dibiarkan merah
- Proyek open source
- Infrastruktur AI
- Indonesia
- 6 September 2026
Tangkapan layar
Gambar tidak dapat dimuat.
Gambar tidak dapat dimuat.
Gambar tidak dapat dimuat.
Gambar tidak dapat dimuat.
Masalahnya
Siapa pun bisa menyambungkan vector store ke LLM dalam satu sore. Perbedaan antara demo itu dan infrastruktur adalah semua yang mengelilingi pipeline: kualitas retrieval yang diukur, bukan dirasakan; independensi dari vendor; observabilitas; dan evaluasi yang berjalan di CI — bukan sekali saat demo. Pandu (bahasa Indonesia untuk “pemandu”) dibangun untuk menunjukkan perbedaan itu: setiap klaim arsitektur di README-nya ditegakkan oleh sebuah gate CI, bukan ditulis begitu saja.
Yang kami bangun
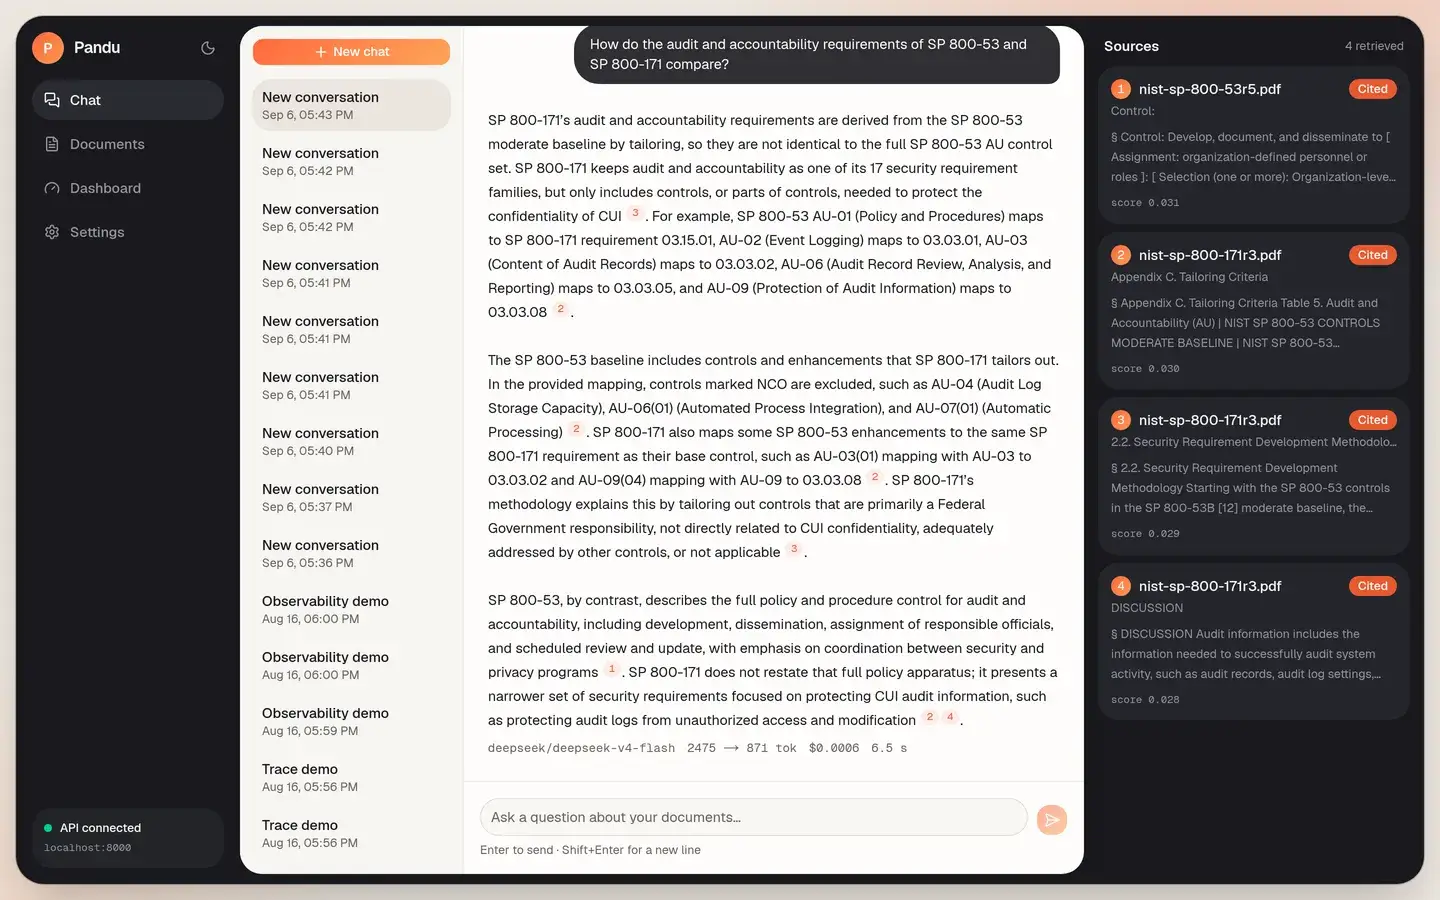
Platform RAG self-hostable: unggah dokumen, ajukan pertanyaan, dapatkan jawaban berstream
dengan sitasi sumber. Backend-nya modular monolith FastAPI dengan batas modul yang
ditegakkan import-linter; satu Postgres memegang data relasional, vektor (pgvector), dan
pencarian leksikal (FTS) sekaligus. Pertanyaan di-embed dan dicari lewat dua lengan
secara paralel — dense (HNSW) dan leksikal — digabung dengan Reciprocal Rank Fusion,
lalu lima konteks teratas masuk ke prompt dengan sitasi bernomor [1][2] yang
diverifikasi oleh kode, bukan diminta lewat prompt.
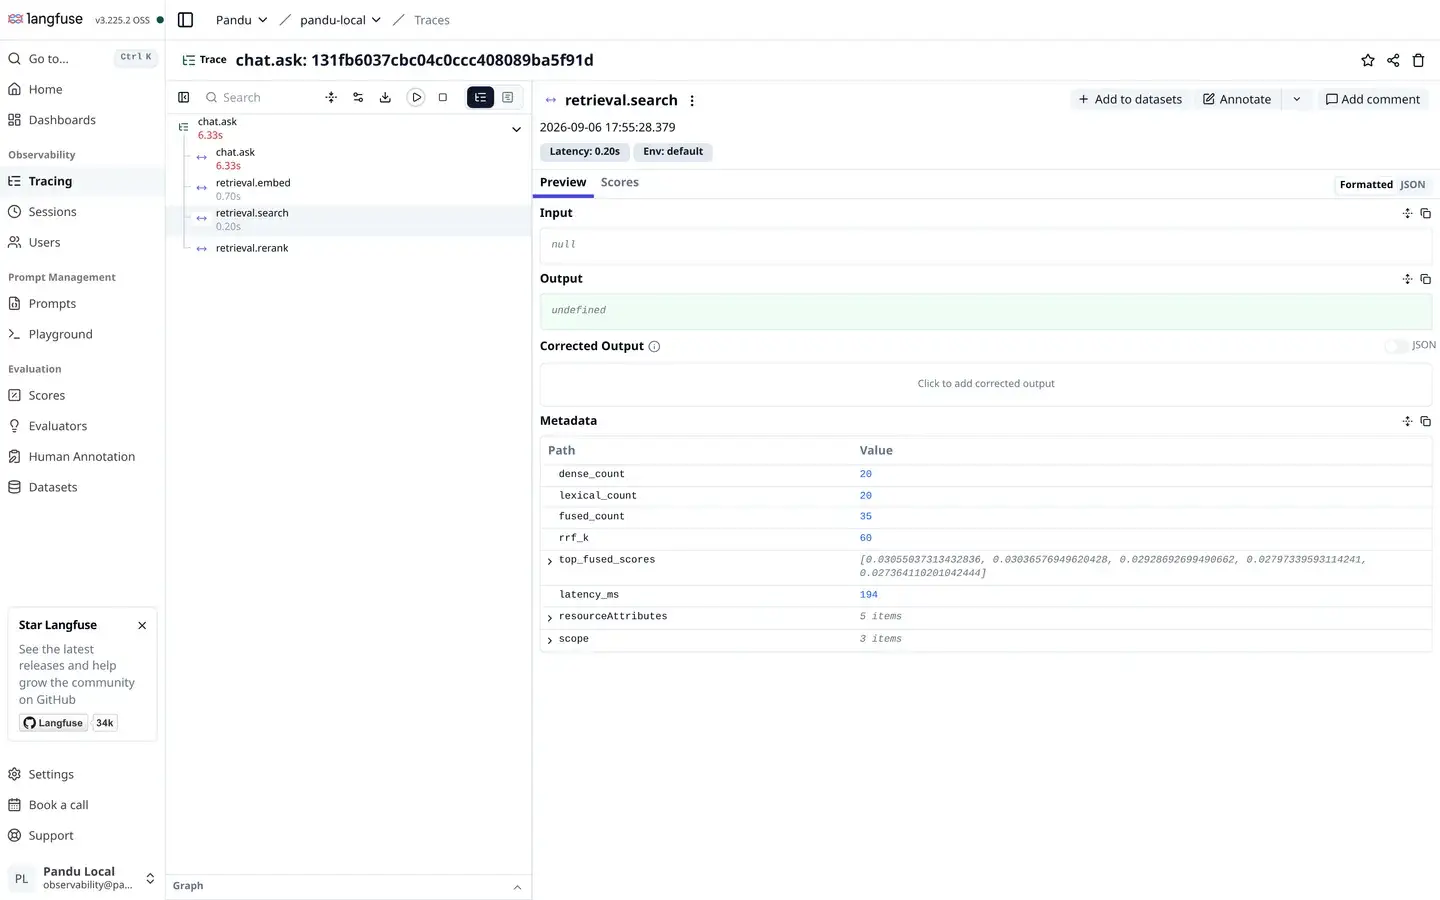
Chat, embedding, dan rerank adalah tiga port terpisah, jadi menambah vendor berarti satu file adapter. Observabilitas lewat Langfuse self-hosted (ClickHouse) merekam id model, jumlah, dan latensi — teks prompt dan dokumen tidak pernah keluar dari aplikasi.
Keputusan rekayasa
Tanpa framework RAG, tanpa gateway SDK. Retrieval ditulis tangan agar setiap bagian bisa diukur, dan seam tempat semua API key mengalir dimiliki sendiri.
Threshold hanya boleh naik. Gate CI (recall@5 ≥ 0,60; faithfulness ≥ 0,85) tidak
pernah dilonggarkan, dan --compare menggagalkan run yang regresi dari run sebelumnya
meski semua threshold absolut lolos — rata-rata bisa berbohong; diff tidak.
Abstention diukur, bukan diprompt. Golden set membawa 5 pertanyaan negatif yang memang tidak bisa dijawab korpus, dan dua arah kesalahan dilaporkan terpisah.
Hasil yang diukur
Di korpus NIST (golden_v2, 2026-09-06): recall@5 0,967, MRR 0,947, nDCG@5 0,920, abstention recall 1,000. Yang lebih berharga dari angkanya adalah cerita di baliknya: sweep konfigurasi menemukan lengan leksikal diam-diam kosong pada 14 dari 20 pertanyaan — “hybrid” berjalan sebagai dense-only selama tiga minggu dengan semua tes hijau, dan baru ketahuan saat provenance per lengan dibaca pada satu pertanyaan. Setelah diperbaiki, hybrid benar-benar mengalahkan dense (nDCG@1 0,933 vs 0,800).
Dan satu gate sengaja dibiarkan merah: faithfulness LLM-judge 0,810 melawan gate 0,85, dengan diagnosis terukur bahwa kasus lintas-dokumen (0,543) adalah defect-nya. Ide perbaikan yang “jelas benar” — cap per dokumen — diukur lalu ditolak dengan angka, bukan dikirim atas dasar hipotesis yang masuk akal. Itu budaya yang dijual repo ini.
Menjalankannya
git clone https://github.com/ridwanspace/pandu && cd pandu && make up — stack penuh
(web :3000, API :8000, Postgres, Redis) lewat Docker Compose. Demo tidak butuh API key:
provider mock deterministik menjalankan seluruh pipeline dan diberi label jelas mock/ extractive; tambahkan satu key provider saat ingin kualitas generasi sungguhan.
Proyek terkait
Ada proses serupa di tim Anda?
Ceritakan alur kerja dan kendalanya. Kita mulai dengan lingkup yang bisa dijelaskan dan diperiksa.