Dalam Stack Overflow Developer Survey 2025, 84% responden memakai atau berencana memakai alat AI dalam proses pengembangannya — naik dari 76% setahun sebelumnya — dan 51% pengembang profesional memakainya setiap hari. Ketika mesin menulis sebagian besar kode, pertanyaan yang tersisa bukan “apakah insinyur masih dibutuhkan”, melainkan “bagian mana dari pekerjaan insinyur yang tersisa”. Jawaban singkatnya: bagian yang justru paling sulit — merumuskan maksud, memecah masalah, dan memverifikasi hasil. Artikel ini membahas mekanismenya, data publik terbaik yang ada, dan batas-batasnya. Yang tidak kami lakukan: menjanjikan percepatan, atau memberi nasihat perekrutan.
Apa yang benar-benar berubah dalam pekerjaan insinyur?
Yang berubah adalah pusat gravitasi pekerjaan: dari mengetik implementasi ke empat hal yang mengelilinginya — merumuskan maksud, memecah masalah, memverifikasi hasil, dan menentukan batas apa yang boleh disentuh agen. Menulis kode tidak hilang, tetapi ia berhenti menjadi bottleneck.
Mekanismenya begini. Pertama, merumuskan maksud: agen mengisi setiap celah dalam instruksi dengan tebakan, dan tebakan yang salah dibayar mahal saat verifikasi — jadi spesifikasi yang tidak ambigu berubah dari formalitas menjadi sumber utama kebenaran. Kedua, memecah masalah: agen bekerja paling baik pada tugas sempit dengan kriteria penerimaan yang jelas, dan memecah sebuah fitur menjadi tugas-tugas sebesar itu adalah keputusan rekayasa, bukan administrasi. Ketiga, memverifikasi: biaya menulis kode turun, tetapi biaya membacanya tidak — setiap diff tetap harus dipahami oleh seseorang yang bisa mempertanggungjawabkannya. Keempat, batas tool dan izin: memutuskan repositori, jaringan, dan kredensial mana yang boleh diakses agen adalah keputusan keamanan yang berpindah ke insinyur, bukan dihapus oleh alatnya.
Keempat beban ini sudah ada sebelum AI; yang berubah adalah proporsinya. Pekerjaan yang dulu 80% menulis dan 20% menilai kini mendekati kebalikannya pada tugas-tugas yang cocok untuk agen.
Apa kata datanya?
Dua sumber publik terbaik menunjukkan gambar yang lebih rumit dari narasi “sepuluh kali lebih cepat”: satu studi terkontrol yang menemukan perlambatan, dan satu survei besar yang menemukan adopsi tinggi dengan kepercayaan menurun.
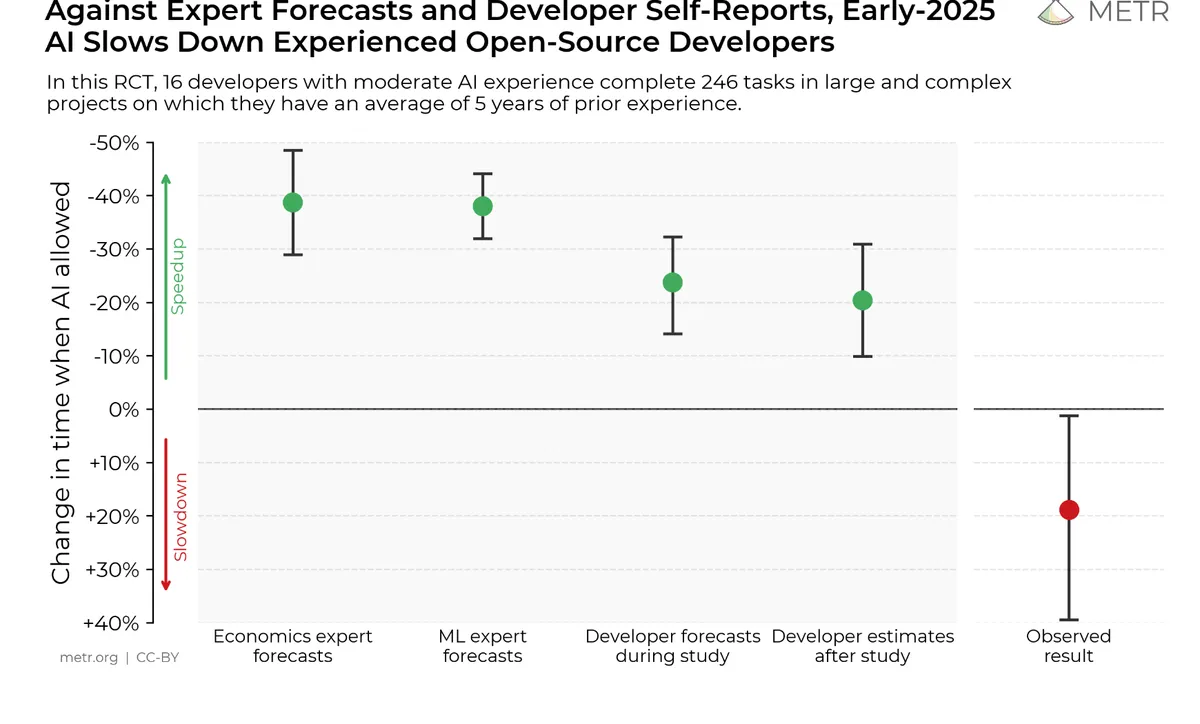
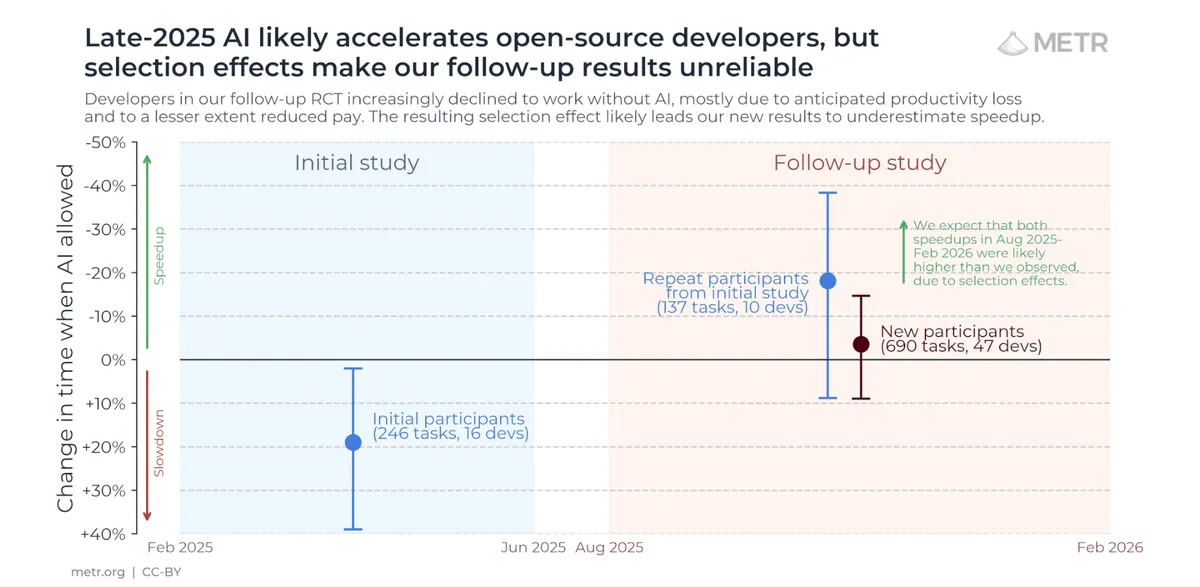
Studi terkontrolnya adalah RCT METR yang diterbitkan 10 Juli 2025. Enam belas pengembang open source berpengalaman — dari repositori besar dengan rata-rata lebih dari 22 ribu bintang dan satu juta baris kode, yang telah mereka rawat bertahun-tahun — mengerjakan 246 issue nyata dari proyek mereka sendiri. Setiap issue diacak: boleh memakai AI (terutama Cursor Pro dengan Claude 3.5/3.7 Sonnet, model frontier saat itu) atau tanpa AI sama sekali. Hasilnya: dengan AI, pengembang 19% lebih lambat menyelesaikan issue (interval kepercayaan +2% hingga +39%). Yang membuat hasil ini terkenal bukan angkanya, melainkan jurang persepsinya: sebelum bekerja, para pengembang memperkirakan AI akan mempercepat mereka 24%; setelah mengalami perlambatan itu sendiri, mereka tetap meyakini diri 20% lebih cepat. Rekaman layar mereka menunjukkan ke mana waktu itu pergi: menyusun prompt, menunggu, membaca, dan mengoreksi output yang hampir benar. METR sendiri memublikasikan daftar klaim yang tidak didukung studinya — antara lain, studi ini tidak membuktikan bahwa AI tidak mempercepat mayoritas pengembang, karena sampelnya adalah pengembang berpengalaman di repositori matang yang mereka kenal luar dalam.
Sumber keduanya adalah survei. Stack Overflow Developer Survey 2025 menemukan sentimen positif terhadap alat AI justru menurun: dari di atas 70% pada 2023 dan 2024 menjadi 60% pada 2025 (sangat positif 22,9%, sangat negatif 9,6%). Kepercayaan pada akurasi output lebih rendah lagi: 46% responden aktif tidak percaya, hanya 33% yang percaya, dan hanya sekitar 3% yang sangat percaya. Yang paling berhati-hati justru pengembang berpengalaman — kelompok dengan tingkat “sangat percaya” terendah (2,6%) dan “sangat tidak percaya” tertinggi (20%). Frustrasi yang paling banyak dikutip (66%) adalah “solusi AI yang hampir benar, tapi tidak persis”, diikuti (45%) oleh “melakukan debug kode buatan AI lebih menyita waktu”. Dan ketika ditanya dalam kondisi apa mereka tetap akan bertanya ke manusia, jawaban nomor satu (75%) adalah “ketika saya tidak percaya jawaban AI”.
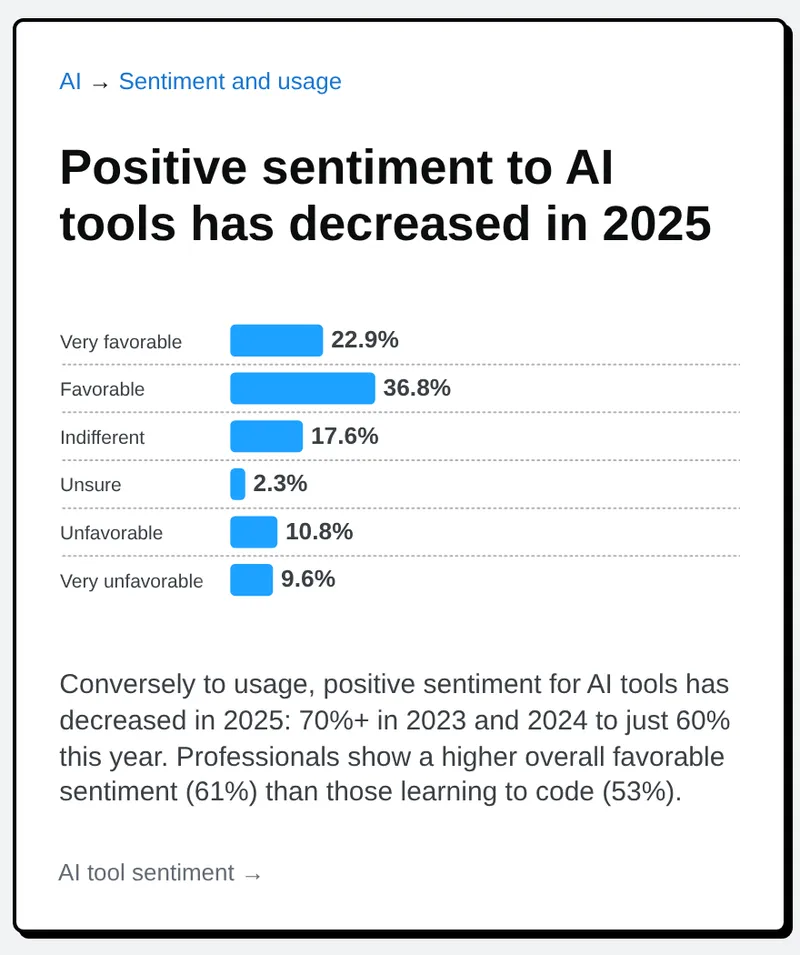
Pembacaan kami — dan ini pembacaan, bukan temuan survei — adalah bahwa angka-angka ini menggambarkan industri yang mengadopsi alat yang outputnya tidak sepenuhnya ia percayai. Itu konsisten dengan peran yang bergeser ke arah verifikasi, bukan dengan peran yang menghilang.
Apakah studi lanjutannya mengubah kesimpulan?
Tidak secara definitif — datanya bergerak, dan pengukurannya justru makin sulit. Pembaruan METR pada 24 Februari 2026 melaporkan eksperimen kedua yang dimulai Agustus 2025 dengan tool yang lebih baru: 10 pengembang dari studi awal ditambah 47 pengembang baru (total 57 pengembang, 143 repositori, lebih dari 800 tugas). Untuk subset pengembang yang kembali, estimasinya berbalik menjadi sekitar 18% lebih cepat — tetapi dengan interval kepercayaan yang sangat lebar (-38% hingga +9%), sementara pengembang baru diestimasi sekitar 4% lebih cepat (interval -15% hingga +9%). Para penulisnya sendiri menyebut data ini “bukti yang sangat lemah” untuk besaran efeknya.
Alasannya adalah efek seleksi yang mereka akui terbuka. Sebagian pengembang menolak berpartisipasi karena tidak mau bekerja tanpa AI; 30% hingga 50% mengaku menyembunyikan sebagian tugas dari randomisasi karena alasan yang sama; bayaran turun dari $150 menjadi $50 per jam, yang ikut menyaring peserta; dan pengukuran waktu menjadi tidak andal bagi pengembang yang menjalankan beberapa agen sekaligus sambil mengerjakan hal lain. Dengan kata lain: semakin berguna AI, semakin sulit mempertahankan kelompok kontrol “tanpa AI”, sehingga estimasinya bias ke bawah dengan cara yang tidak bisa dikoreksi dari datanya. Ditambah temuan studi pertama bahwa perkiraan diri pengembang bisa meleset 40 poin persentase dari realitas, pelajarannya praktis: ukur pekerjaan Anda sendiri, jangan meminjam estimasi titik dari studi orang lain.
Seperti apa pekerjaan orkestrasi secara konkret?
Bentuknya adalah dokumen: spesifikasi yang ditulis manusia, pemecahan menjadi tugas agen yang masing-masing punya kriteria penerimaan, dan gerbang verifikasi di antara keduanya. Contoh ilustratif berikut — bukan proyek klien dan bukan hasil pengukuran — menunjukkan apa yang seorang orkestrator tulis sebelum satu agen pun berjalan, untuk fitur “tambahkan alur refund”:
Fitur: alur refund untuk pesanan yang dibatalkan pelanggan (contoh ilustratif)

Spesifikasi (ditulis dan ditinjau manusia sebelum agen berjalan):
- Refund hanya untuk pesanan berstatus "dibatalkan" yang belum pernah direfund
- Dana kembali ke metode pembayaran asal; konfirmasi dalam 3-7 hari kerja
- Setiap refund tercatat di audit log dengan idempotency key yang unik

Pemecahan tugas agen:
1. Migrasi skema: tabel refunds + constraint unik pada idempotency key
   Gerbang: migrasi berjalan maju dan mundur di staging
2. Endpoint POST /orders/{id}/refund dengan validasi status pesanan
   Gerbang: test kontrak lulus, termasuk kasus double-submit
3. Integrasi payment gateway + penanganan webhook status refund
   Gerbang: replay webhook di sandbox; retry tidak menghasilkan refund ganda
4. Notifikasi email + entri audit log
   Gerbang: snapshot test template; tidak ada refund tanpa entri audit

Batas tool: agen boleh menulis kode dan menjalankan test; dilarang mengakses
kredensial produksi; migrasi dijalankan manual setelah review manusia.
Perhatikan di mana jam kerja insinyur berpindah: hampir semuanya ke spesifikasi dan gerbang. Aturan yang membuat gerbang berarti adalah menuliskan kriteria penerimaan sebelum melihat output agen — gerbang yang tidak bisa gagal bukanlah gerbang, melainkan stempel.
Bagaimana pergeseran ini berbeda di tiap konteks?
Mekanismenya sama di mana-mana; yang berbeda adalah di mana pajak verifikasinya jatuh dan siapa yang membayarnya.
Pendiri tunggal. Satu orang menjadi penulis spesifikasi, orkestrator, dan reviewer sekaligus. Risiko utamanya bukan kualitas agen, melainkan tidak adanya mata kedua — kompensasinya adalah test yang ketat, scope perubahan yang kecil, dan kejujuran tentang bagian sistem yang sebenarnya tidak Anda pahami.
Tim produk kecil. Pembagian kerja mulai muncul: satu insinyur menulis spesifikasi, agen dan kolega mengeksekusi, dan review menjadi bottleneck yang sebenarnya — bukan penulisan kode. Antrian pull request yang menumpuk adalah gejala pergeseran ini, bukan kebetulan.
Perusahaan teregulasi. Batas tool dan izin pindah ke pusat pekerjaan: setiap agen butuh audit trail, jawaban atas “kode siapa ini” adalah pertanyaan kepatuhan, dan evaluasi serta observabilitas menjadi prasyarat sebelum agen boleh menyentuh sistem nyata. Inilah alasan kami membangun harness evaluasi LLM sebagai fondasi, dan mengapa layanan agen AI kami selalu dimulai dari gerbang dan batas izin, bukan dari prompt.
Siapa yang lebih diuntungkan, senior atau junior?
Dari data yang ada, senior — dan alasannya mekanis: pajak verifikasi berskala dengan seberapa banyak yang Anda tahu. Pengembang senior tahu di mana kesalahan biasanya bersembunyi, sehingga bisa mengenali output yang hampir benar tapi salah halus sebelum ia mahal. Pengembang junior menerima output yang sama fasihnya, tanpa model mental sistem untuk mengujinya. Data survei sejalan: dalam Stack Overflow 2025, pengembang berpengalaman adalah kelompok paling skeptis terhadap akurasi AI (“sangat tidak percaya” 20%, tertinggi di antara semua kelompok), dan studi METR justru meneliti pengembang paling senior di repositori yang mereka kenal bertahun-tahun — orang-orang yang paling siap memverifikasi — dan tetap menemukan pajaknya nyata. Ini pembacaan kami atas data tersebut, bukan rekomendasi perekrutan: data ini tidak menjawab siapa yang sebaiknya dipekerjakan.
Bagaimana dengan pandangan yang berlawanan?
Dua pandangan populer sama-sama setengah benar. Pandangan “agen akan menggantikan penulisan kode sepenuhnya” bertahan pada tugas yang sempit dengan penilaian otomatis — benchmark, prototipe sekali pakai — dan tabel perbandingan METR sendiri mencatat agen berhasil pada tugas benchmark yang sulit bagi manusia; ia patah tepat di definisi sukses studi lapangan: manusia yang puas kodenya akan lolos review, termasuk gaya, test, dan dokumentasi. Pandangan sebaliknya, “ini hanya autocomplete”, patah oleh data adopsi — 51% pengembang profesional memakai AI setiap hari dan agen sudah masuk alur kerja nyata — tetapi bertahan pada satu hal penting: batas tanggung jawab belum bergerak, dan kode yang tidak dibaca manusia tetap kode yang tidak bisa dipertanggungjawabkan. Perdebatan keduanya, dalam pembacaan kami, lebih banyak soal skala waktu dan jenis tugas daripada soal apakah verifikasi tetap pekerjaan manusia.
Keterampilan apa yang naik nilainya?
Penilaian, bukan pengetikan. Ketika menulis kode menjadi murah, yang mahal adalah: menulis spesifikasi yang tidak ambigu; review — mengenali output yang hampir benar; merancang evaluasi, yaitu kriteria penerimaan dan harness yang bisa gagal dengan jujur; debugging sistem, menjawab “mengapa” ketika sesuatu rusak di produksi; dan merancang batas tool serta izin untuk agen. Kelimanya adalah keterampilan yang selama ini menandai insinyur senior; bedanya, sekarang kelimanya menjadi deskripsi pekerjaan utama, bukan pelengkap.
Apa yang belum terjawab?
Banyak, dan sebaiknya diakui. Data produktivitas bergerak cepat — studi yang sama menghasilkan perlambatan pada awal 2025 dan percepatan tentatif pada awal 2026 — dengan efek seleksi yang membuat angka terbaru sulit dipercaya penuh. Sampel studi terkontrolnya kecil dan khusus: pengembang open source berpengalaman di repositori matang, bukan tim enterprise dengan basis kode internal. Perkiraan diri terbukti tidak andal. Tidak ada sumber di atas yang menetapkan efek untuk domain di luar pengembangan perangkat lunak, untuk model yang belum ada, atau untuk kebijakan perekrutan — artikel ini sengaja tidak membahas struktur tim atau nasihat karier individu. Sumber diperiksa pada 1 Oktober 2026; jika Anda membaca ini jauh setelahnya, anggap angkanya sebagai titik awal untuk diperiksa ulang, bukan kesimpulan.
Peran insinyur berubah bentuk; tanggung jawabnya tidak. Jika organisasi Anda sedang memetakan ulang peran rekayasa atau menata gerbang verifikasi untuk sistem agenik, bicara dengan kami.