Pertanyaan ini wajar, dan semakin sering kami dengar: kalau AI bisa menulis kode, mengapa repot belajar pemrograman? Jawaban singkatnya: karena nilai Anda di era AI justru terletak pada kemampuan menilai kode yang ditulis AI — dan kemampuan itu tidak bisa dihasilkan AI untuk Anda. Artikel ini membela argumen tersebut dengan dua riset yang bisa Anda periksa sendiri, dengan batasannya dinyatakan terus terang. Kami tidak akan mengklaim AI melemahkan otak programmer — buktinya belum sekuat itu — tetapi menyerahkan seluruh penulisan kode kepada AI punya biaya, dan biaya itu ditanggung keterampilan Anda sendiri.
Apa kata riset tentang ketergantungan pada AI?
Satu preprint yang paling sering dikutip adalah “Your Brain on ChatGPT” oleh Kosmyna dan rekan-rekan dari MIT Media Lab, diterbitkan di arXiv pada 2025. Mereka mengukur aktivitas otak 54 peserta dengan EEG saat menulis esai dalam tiga kelompok: menggunakan LLM, menggunakan mesin pencari, dan tanpa alat bantu sama sekali. Kelompok LLM menunjukkan konektivitas saraf terlemah dari ketiganya, dan banyak anggotanya kesulitan mengutip esai yang baru saja mereka tulis sendiri. Para penulis membingkai temuan ini sebagai “cognitive debt” — utang kognitif yang menumpuk saat kerja berpikir dialihkan ke mesin.
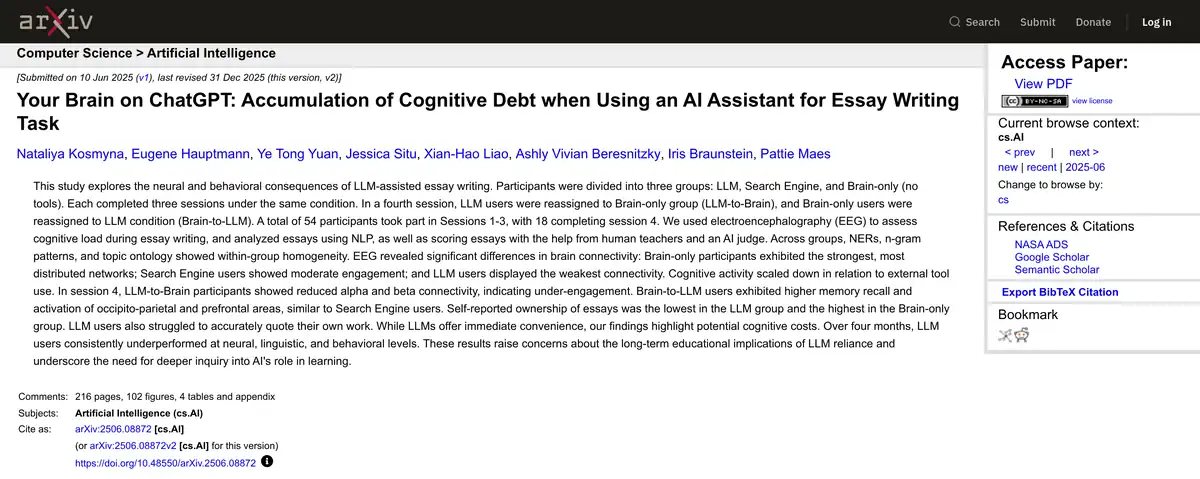
Dua batasan itu penting dan kami ulangi karena sering hilang saat makalah ini dikutip di media sosial. Pertama, ini preprint: belum ditinjau sejawat, dan para penulisnya sendiri meminta hasilnya tidak digeneralisasi. Kedua, tugasnya menulis esai SAT, bukan menulis kode — tidak ada programmer dalam eksperimen ini. Jadi temuannya sugestif, bukan final: pada satu tugas kognitif, delegasi penuh ke LLM berkorelasi dengan keterlibatan otak lebih rendah dan ingatan lebih buruk terhadap hasil kerja sendiri. Alasan untuk waspada, bukan vonis.
Mengapa kode yang “hampir benar” lebih berbahaya daripada kode yang jelas salah?
Karena kode yang jelas salah menolak bekerja, sedangkan kode yang hampir benar bekerja — sampai suatu hari tidak. Inilah mekanisme atrofi keterampilan di pemrograman, dan ia bekerja bahkan tanpa perubahan apa pun di otak Anda.
AI menggeser pekerjaan dari menulis ke memverifikasi. Kedengarannya lebih ringan, tetapi verifikasi bukan keterampilan yang lebih rendah — ia keterampilan yang sama dalam bentuk yang lebih murni. Untuk menilai apakah fungsi yang dihasilkan AI benar, Anda harus bisa membacanya, memahami maksudnya, melihat kasus tepi yang tidak ditanganinya, dan mengenali ketika ia menyelesaikan masalah yang salah dengan cara yang benar. Semua itu hanya dibangun dengan menulis dan memperbaiki kode sendiri, bertahun-tahun.
Output LLM memperburuk situasi ini lewat gayanya: kode yang tampak percaya diri, penamaan rapi, struktur idiomatis, kadang lengkap dengan komentar. Kode seperti itu lulus penilaian sekilas. Kesalahannya — pembagian dengan nol pada input tertentu, race condition yang baru muncul di bawah beban — tersembunyi di balik permukaan yang meyakinkan. Pengembang berpengalaman membacanya dengan kecurigaan terlatih; pemula yang belum pernah membangun apa pun sendiri tidak punya dasar untuk curiga. Di sinilah atrofi bekerja: bukan karena AI membuat Anda malas, tetapi karena setiap tugas yang didelegasikan penuh adalah satu repetisi latihan yang hilang — dan repetisi itulah yang membangun kemampuan memverifikasi.
Apa yang ditemukan studi METR tentang pengembang berpengalaman?
Temuan paling mengejutkan datang dari METR pada 10 Juli 2025: dalam uji coba terkontrol acak, pengembang open source berpengalaman justru 19% lebih lambat dengan alat AI — padahal mereka merasa sekitar 20% lebih cepat.
Pesertanya bukan pemula: pengembang dengan pengalaman bertahun-tahun di repositori besar yang sudah mereka kenal. METR mengacak tugas nyata dari repositori itu ke dua kondisi, dengan dan tanpa AI, lalu mengukur waktu penyelesaiannya. Perkiraan para pengembang, maupun para ahli yang diminta menebak, adalah percepatan. Yang terukur: perlambatan 19%. Sebagian penyebabnya, menurut METR, adalah waktu meninjau dan mengoreksi output AI — prompt yang disusun, respons yang dibaca, kode hampir benar yang diperbaiki. Celah antara persepsi dan kenyataan itu sendiri temuan penting: orang merasa lebih cepat karena mengetik lebih sedikit, padahal jam berkata lain.
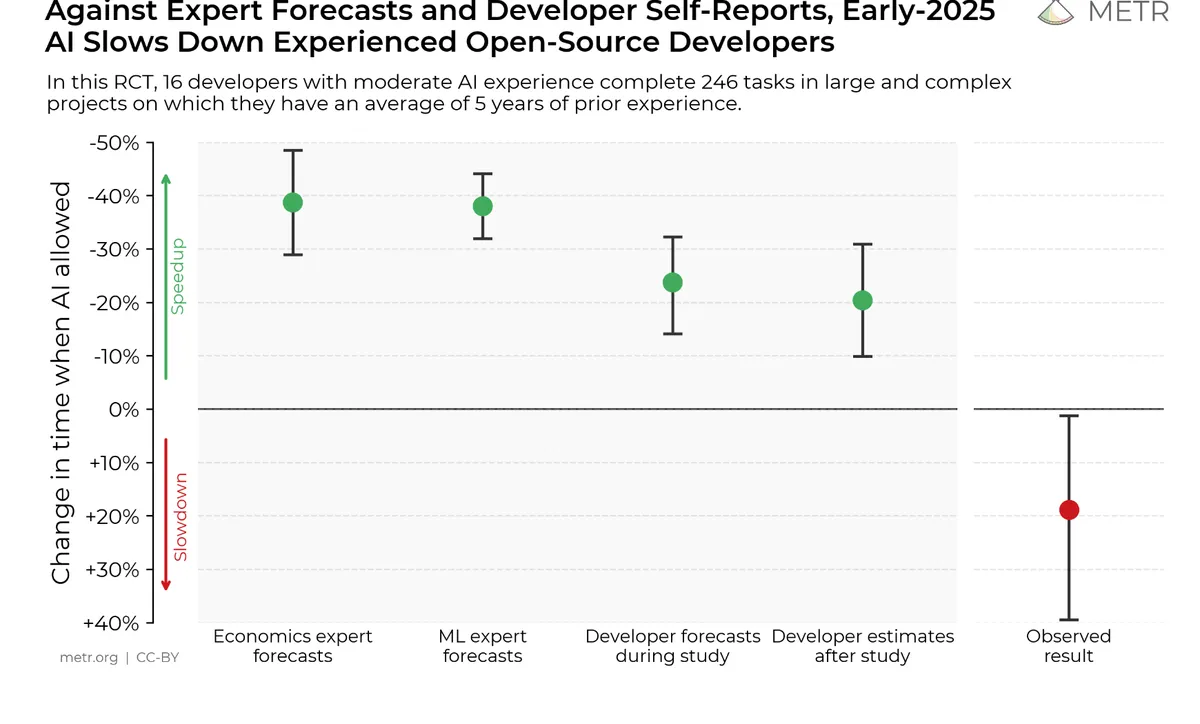
Ada pelajaran kedua yang lebih halus. Para pengembang ini bisa menangkap kesalahan output AI justru karena berpengalaman: mereka tahu bagaimana kode di repositori itu seharusnya terlihat, sehingga penyimpangan kecil langsung terasa janggal. Pengalaman itulah yang membuat verifikasi mungkin sekaligus mahal. Bayangkan pengembang tanpa pengalaman itu: output sama, kesalahan halus sama, tetapi tidak ada yang menangkapnya. Perlambatan 19% adalah harga yang dibayar senior untuk tetap akurat; junior yang tidak membangun keterampilannya membayar harga lain — kesalahan yang lolos ke produksi.
Siapa yang paling berisiko mengalami atrofi keterampilan?
Risiko ini tidak merata. Tiga situasi yang kami nilai paling rentan:
Mahasiswa yang menimbang apakah fundamental masih penting. Godaannya besar: tugas bisa selesai dengan satu prompt, jadi mengapa menghafal struktur data? Jawabannya ada pada studi di atas — tanpa fundamental, tidak ada cara menilai jawaban AI untuk masalah yang lebih sulit dari tugas kuliah. Gelar lewat delegasi penuh adalah gelar tanpa keterampilan di baliknya, dan itu ketahuan di pekerjaan pertama.
Career switcher di bootcamp yang berat pada AI. Banyak program pelatihan sekarang mengajarkan “membangun aplikasi dengan AI” sebagai jalan pintas — berguna untuk motivasi dan portofolio cepat, tetapi berbahaya sebagai satu-satunya mode belajar. Jika setiap proyek latihan ditulis AI, yang terlatih adalah keterampilan mem-prompt, bukan memprogram — dan pasar kerja masih menguji yang kedua di wawancara teknis.
Pengembang senior yang keterampilannya berkarat diam-diam. Kasus yang paling jarang dibahas. Senior yang mendelegasikan seluruh penulisan kode selama dua tahun tidak akan sadar apa yang hilang, karena pekerjaannya tetap selesai. Atrofi baru terlihat saat ia harus men-debug tanpa AI, menulis sesuatu yang AI-nya tidak kuasai, atau pindah ke toolchain lain. Keterampilan yang tidak dipakai hilang perlahan, dan baru terasa ketika dibutuhkan.
Bagaimana cara belajar dengan AI tanpa dirusak olehnya?
Prinsipnya satu kalimat: perlakukan AI sebagai tutor, bukan pengganti berpikir. Di kalangan pengembang, aturannya dikenal sebagai “read the diff” — output AI boleh masuk ke basis kode, tetapi hanya lewat pemahaman Anda. Berikut protokol yang kami sarankan, dan kami tandai dengan jelas: ini praktik editorial kami, bukan protokol teruji dari riset di atas.
- Coba dulu sendiri. Sebelum membuka AI, tulis versi Anda sendiri — sekalipun buruk, sekalipun hanya pseudocode. Usaha awal inilah yang oleh penelitian pembelajaran disebut desirable difficulty: justru kesulitannya yang membuat penjelasan menempel.
- Minta penjelasan, bukan solusi. Bila mentok, minta AI menjelaskan konsep atau menunjukkan arah, lalu tulis kodenya sendiri. Jawaban utuh yang disalin tidak meninggalkan apa pun di kepala Anda.
- Baca setiap diff. Tidak ada output AI yang masuk tanpa dibaca baris per baris. Baris yang tidak bisa Anda jelaskan adalah tanda untuk bertanya lagi — bukan untuk diabaikan.
- Satu proyek tanpa AI setiap pekan. Bangun sesuatu yang kecil secara manual, dari nol. Bukan nostalgia: ini cara menguji apakah keterampilannya masih milik Anda, sekaligus menjaga repetisi di balik intuisi verifikasi.
Pola adopsi yang sehat seperti ini — alat mempercepat orang yang tetap kompeten, bukan menggantikan kompetensinya — juga bagian dari konsultasi dan pelatihan AI yang kami tawarkan untuk tim.
Bukankah ini argumen yang sama dengan soal kalkulator?
Sepintas ya, dan analoginya layak dijawab serius. Versi klasiknya: orang dulu khawatir kalkulator merusak kemampuan berhitung, ternyata kalkulator hanya membebaskan kita untuk matematika yang lebih tinggi. Mengapa AI tidak sama?
Karena satu perbedaan menentukan: kalkulator deterministik dan terverifikasi. 7 × 8 selalu 56, di kalkulator mana pun, dan Anda bisa memeriksanya dengan cara yang independen dari kalkulator itu. Output LLM tidak punya dua sifat ini. Pertanyaan yang sama bisa memberi jawaban berbeda di dua pemanggilan, tidak ada prosedur pemeriksa independen selain pemahaman Anda sendiri, dan jawaban yang salah disampaikan dengan nada semeyakinkan jawaban yang benar. Analogi yang lebih jujur bukan kalkulator, melainkan co-pilot di kokpit: berguna, bahkan perlu, tetapi pilot tetap wajib bisa menerbangkan pesawat — co-pilot bisa salah dan tidak akan memberi tahu kapan.
Analogi kalkulator tetap menyimpan satu kebenaran: alat memang menggeser apa yang layak dipelajari. Menghafal sintaksis tidak lagi sepenting dulu, dan itu wajar. Yang tidak bergeser adalah kemampuan membaca, menilai, dan memperbaiki kode — ketiganya lahir dari praktik menulis.
Bagaimana dengan pandangan “AI mengurus semuanya, belajar prompting saja”?
Pandangan ini perlu di-steelman, bukan ditertawakan. Versi terkuatnya: kemampuan model naik terus, sebagian pekerjaan pemrograman memang akan berpindah ke perumusan masalah dan orkestrasi agen, jadi keterampilan yang layak dibangun adalah menyusun spesifikasi dan mengelola output — bukan menulis loop.
Sebagian benar. Peran memang bergeser, dan menyusun spesifikasi yang baik adalah keterampilan nyata yang kami hargai. Tetapi ia gagal di dua tempat. Pertama, spesifikasi dan orkestrasi yang baik menuntut pemahaman teknis yang dalam: Anda tidak bisa menulis spesifikasi ketat untuk sistem yang tidak Anda pahami, dan tidak bisa mengevaluasi agen di domain yang asing bagi Anda. Kedua, pandangan ini bertaruh pada masa depan yang belum tiba. Studi METR di atas — model awal 2025, pengembang sangat berpengalaman, repositori yang mereka kuasai — menunjukkan alatnya belum mempercepat bahkan pengguna terbaiknya. Bertaruh karier pada “nanti modelnya cukup pintar” adalah bertaruh pada janji, bukan pengukuran.
Dan verifikasi tidak hilang ketika pekerjaan berpindah ke agen. Justru sebaliknya: sistem agenik butuh eval, guardrail, dan peninjauan output yang lebih disiplin, karena kesalahan agen berlipat ganda di setiap langkah yang ia ambil sendiri. Ini pekerjaan yang kami lakukan setiap hari di layanan agen AI kami, dan tidak satu pun bisa dilakukan oleh orang yang tidak memahami kode di baliknya.
Apa batasan argumen ini?
Terus terang, beberapa. Bukti neurologisnya satu preprint yang belum ditinjau sejawat, dengan tugas menulis esai — bukan pemrograman, dan 54 peserta bukan sampel besar. METR mengukur pengembang berpengalaman di repositori yang mereka kenal dengan alat awal 2025; hasilnya tidak otomatis berlaku untuk pemula, model terbaru, atau jenis pekerjaan lain. Tidak ada riset yang kami kutip yang meresepkan kurikulum — protokol belajar di atas adalah praktik yang kami sarankan, bukan temuan ilmiah. Artikel ini juga sengaja tidak membahas bahasa pertama atau sumber belajar tertentu.
Sumber diperiksa pada 1 Oktober 2026. Jika tim Anda ingin mengadopsi AI sambil tetap membangun keterampilan inti anggotanya, bicara dengan kami.